Cos'è Jev
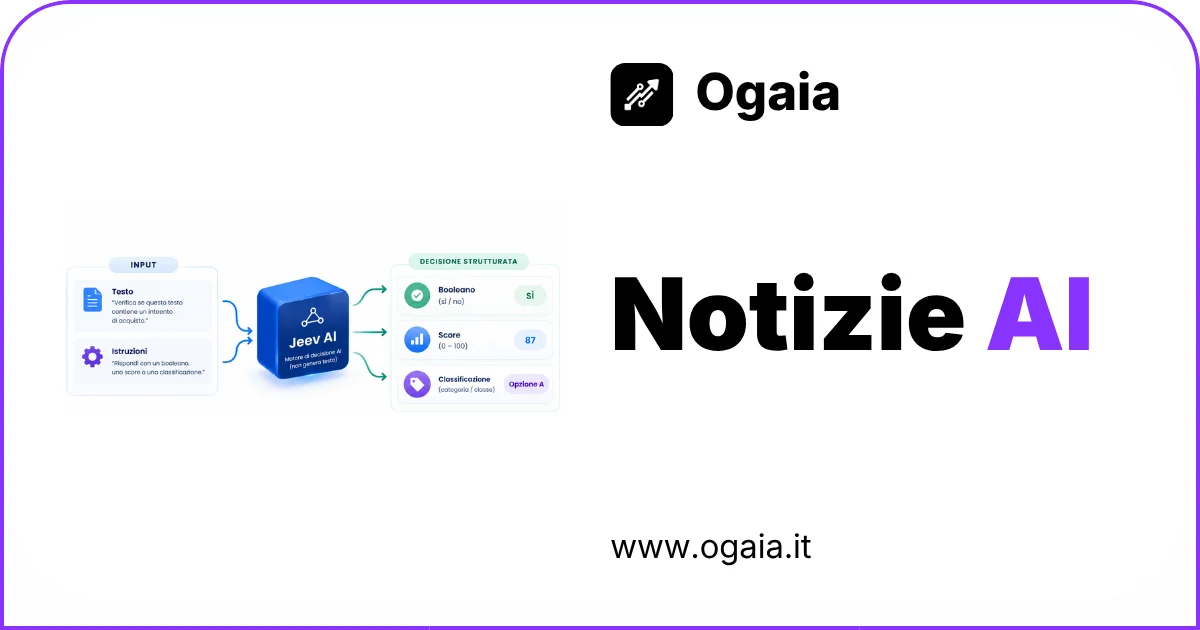
Jev è il primo modello della categoria "System 1 Model", sviluppato dal laboratorio TypeSafe AI e lanciato pubblicamente il 15 settembre 2026. Non è un chatbot e non è un large language model nel senso classico: non genera testo, non si può conversare con lui, e non produce una risposta parola per parola. Riceve in input dello stato (un testo non strutturato) e delle istruzioni in linguaggio naturale, e restituisce esclusivamente una tra tre cose: un valore booleano (sì o no), un punteggio numerico, oppure una scelta tra opzioni che tu stesso gli fornisci.
È, in pratica, un motore di decisione istantaneo che capisce il linguaggio naturale come un LLM, ma invece di scrivere una risposta la restituisce come probabilità calcolata in un solo passaggio, senza generare token. Questa differenza architetturale è il motivo per cui è drasticamente più veloce ed economico su compiti di classificazione, scoring e instradamento.
Fonte: TypeSafe AI, Jev.
Come funziona Jev
Il funzionamento si capisce meglio confrontandolo con un LLM tradizionale sullo stesso compito.
Tre canali di input, tre soli tipi di output
A Jev si passano tre cose distinte: lo stato (il testo grezzo su cui ragionare, ad esempio un curriculum o una pagina web), le istruzioni (cosa deve valutare, in linguaggio naturale) e, quando serve una scelta, le opzioni ammesse, che devi elencare tu. Il modello non inventa mai le categorie: gliele fornisci come "criteri" e lui distribuisce la probabilità solo su quelle.
L'output è sempre uno dei tre tipi, e puoi chiedergli più risposte in parallelo nella stessa chiamata: uno score sugli anni di esperienza, una classificazione del settore e un booleano su un requisito, tutto in un'unica interrogazione invece di tre passaggi separati.
Perché è più veloce: niente generazione token per token
Un LLM che deve produrre un JSON strutturato scrive il risultato carattere per carattere: apre la graffa, scrive la chiave, i due punti, il valore, la virgola, e così via, un token alla volta. Jev salta questo passaggio: legge il testo con un transformer, poi invece di generare la sequenza di token della risposta, legge direttamente le probabilità calcolate sulle opzioni permesse. Tecnicamente si prende un modello decoder-only, lo si tronca subito dopo il livello che normalmente calcolerebbe la probabilità di ogni token del vocabolario, e al suo posto si aggiungono teste di classificazione dedicate: una sigmoide per i booleani e gli score, una softmax per le scelte multiple. Fonte: Archer Hume, Jev's Architecture Unmasked, 2026 (analisi tecnica indipendente: TypeSafe non ha pubblicato un paper ufficiale).
In un test indipendente su un compito di classificazione ripetuta, in 12 secondi Jev ha completato 47 decisioni con una latenza media di 227 millisecondi. Nello stesso tempo, Gemini 3.8 Flash ne ha completate 3, Claude Haiku 4.5 ne ha completate 2 e GPT-5.6 Sol ne ha completate 2. Fonte: RuntimeWire, TypeSafe raises $40M for Jev, 2026 (misurazione su una singola esecuzione, 17 settembre 2026).
Sul costo, TypeSafe dichiara un modello 193,6 volte più veloce e 444,6 volte più economico rispetto a un LLM di riferimento sullo stesso compito (0,114 secondi e 0,000081 dollari contro 8,566 secondi e 0,013880 dollari). Nel video che ha reso Jev virale in Italia circolava la cifra di "44 volte più economico": è probabilmente un arrotondamento impreciso del 444,6x dichiarato ufficialmente, quindi nell'articolo usiamo il dato pubblicato da TypeSafe, non quello riportato a voce. Fonte: TypeSafe AI, pagina citata sopra.
Chi l'ha costruito
Il fondatore, Diogo Almeida, non è un tecnico qualunque: ha lavorato circa quattro anni e mezzo in OpenAI, dove è co-inventore del Reinforcement Learning from Human Feedback ed è tra gli autori principali del paper InstructGPT del 2022, la tecnica che ha permesso di trasformare GPT in ChatGPT. Compare inoltre tra i contributori del report tecnico di GPT-4. Prima di OpenAI ha lavorato in Google Brain. TypeSafe AI, fondata insieme a Erik Gafni e Sasha Sheng, è rimasta in stealth per circa due anni prima del lancio, e ha raccolto 40 milioni di dollari in un round Seed guidato da DCVC. Fonte: RuntimeWire, 2026.
Jev per le PMI italiane
La domanda pratica non è se Jev sia intelligente quanto un large language model in generale: su una conversazione aperta non lo è, perché non conversa affatto. La domanda giusta è dove un'azienda ha oggi un LLM che fa solo lavoro di classificazione, e potrebbe sostituirlo con qualcosa di più veloce ed economico.
| Caso d'uso | Cosa fa oggi un LLM | Dove Jev converrebbe |
|---|---|---|
| Screening curriculum | Genera un JSON con anni di esperienza, settore, punteggio | Stesso output, senza generare testo, su migliaia di CV |
| Triage assistenza clienti | Classifica urgenza, sentiment, reparto competente | Risposta istantanea, instrada il ticket senza attesa |
| Classificazione documenti | Distingue fatture da altri file in una cartella | Su grandi volumi, dove la velocità abbatte i costi |
| Guardrail su un agente AI | Un secondo LLM controlla se una richiesta è sicura | Filtro istantaneo, non rallenta l'esperienza utente |
Il filo comune è che questi non sono compiti dove serve creatività o conversazione: sono decisioni ripetitive con un numero finito di esiti possibili. È lo stesso terreno su cui lavorano gli agenti AI per le PMI, con la differenza che qui non serve nemmeno addestrare un modello dedicato: bastano stato e istruzioni scritte bene.
Il claim delle "zero allucinazioni": cosa c'è di vero
TypeSafe dichiara che Jev ha zero allucinazioni. È un'affermazione da prendere con cautela, e vale la pena spiegare perché, perché è un errore concettuale comune quando si parla di modelli statistici.
Quello che Jev garantisce davvero è che l'output sia sempre nel formato corretto: se gli chiedi un booleano, ottieni un booleano valido, non un testo malformato o un campo mancante. Questo elimina un tipo di errore reale e frequente negli LLM, quello del JSON rotto o della risposta fuori schema. Ma non elimina l'errore di contenuto: Jev resta un modello statistico, quindi può assegnare un'alta probabilità alla scelta sbagliata, esattamente come un LLM può scrivere un fatto falso con sicurezza.
Un test semplice lo dimostra: chiedendo a Jev di stimare l'età di una persona sulla base del solo nome, il modello assegna una probabilità alta a una fascia d'età sbagliata, perché semplicemente non ha l'informazione. Non è un JSON malformato, è una previsione statisticamente sicura ma fattualmente errata: la stessa dinamica di un'allucinazione, in una forma diversa. La correzione pratica è aggiungere sempre un'opzione esplicita "non lo so" tra le scelte disponibili: forzato a scegliere solo tra risposte plausibili, il modello tende a preferirla quando l'informazione richiesta non è nello stato che gli hai fornito.
Come l'AI sta cambiando l'automazione nel 2026
Jev introduce nel linguaggio comune una distinzione presa in prestito dalla psicologia cognitiva: sistemi di "Pensiero Sistema 1", veloci e istintivi, contro il "Sistema 2" lento e deliberativo dei large language model che ragionano passo passo. Il 2026 sta mostrando che il futuro dell'automazione non è scegliere l'uno o l'altro, ma farli lavorare insieme.
Il caso d'uso più promettente emerso è usare Jev come strumento a disposizione di un LLM agentico: un agente basato su un modello conversazionale riceve una richiesta complessa dall'utente, ragiona su come scomporla, e poi delega a Jev tutte le micro-decisioni ripetitive, come smistare centinaia di documenti o valutare quale strumento richiamare tra decine disponibili. Il ragionamento resta all'LLM, l'esecuzione veloce va a Jev. È lo stesso principio con cui in un'azienda una persona senior decide la strategia e delega l'esecuzione ripetitiva a chi è più rapido su quel compito specifico.
Quanto costa Jev
Il pricing pubblicato da TypeSafe è di 42 dollari per miliardo di token in input, pari a circa 0,042 dollari per milione di token, e zero dollari per l'output, perché non genera token in uscita: l'intero costo di un LLM legato alla scrittura della risposta, in questo caso, semplicemente non esiste.
| Voce | Jev | LLM di riferimento (stesso task) |
|---|---|---|
| Costo per decisione | 0,000081 dollari | 0,013880 dollari |
| Tempo di risposta | 0,114 secondi | 8,566 secondi |
Su volumi alti, dove oggi molte aziende usano l'elaborazione in batch per contenere i costi (con tempi di attesa fino a 24 ore per ricevere i risultati), la differenza diventa strutturale: si passa da un processo asincrono che richiede un giorno intero a un flusso che risponde in una frazione di secondo, senza il compromesso tra costo e velocità. Fonte: TypeSafe AI, pagina citata sopra.
Il calcolo va comunque sempre chiuso sul beneficio reale, non sul solo prezzo per token: lo stesso approccio (tempo risparmiato per attività, moltiplicato per il volume mensile) che usiamo per stimare quanto costa davvero l'AI in azienda vale anche qui.
Come iniziare: i 3 passi per una PMI italiana
Nessuno di questi passi richiede di riscrivere l'infrastruttura esistente.
Passo 1: individua un compito di sola classificazione
Cerca un punto del tuo flusso di lavoro dove oggi un LLM (o una persona) si limita a etichettare, valutare o smistare, senza scrivere testo libero. È il candidato ideale: instradamento email, qualifica lead, smistamento documenti.
Passo 2: scrivi criteri chiari, non vaghi
La qualità delle decisioni di Jev dipende dalla precisione delle istruzioni e dalla lista di opzioni che gli fornisci. Descrivi esplicitamente quando una risposta è vera e quando è falsa, invece di lasciare margini di interpretazione: è la differenza tra un modello utile e uno impreciso.
Passo 3: aggiungi sempre l'opzione "non lo so"
Per ogni scelta o punteggio che richiedi, prevedi una via d'uscita esplicita per i casi in cui l'informazione nello stato non basta. È l'unico modo per distinguere una decisione affidabile da un'ipotesi statistica travestita da certezza.
Come Ogaia costruisce sistemi AI per le PMI
In Ogaia | Soluzioni AI & Customer generation per Aziende Italiane valutiamo ogni nuova architettura, Jev compreso, con lo stesso criterio: non "è la novità del momento" ma "risolve un problema specifico della tua azienda più velocemente o a un costo più basso di quello che usi oggi". Un sistema di automazione ben costruito combina più strumenti, non ne insegue uno solo, e sceglie il modello giusto in base al compito reale, non alla notorietà del nome.
Se vuoi capire quali decisioni ripetitive della tua azienda potrebbero già oggi essere automatizzate a costo quasi zero, prenota una call gratuita di 45 minuti: uscirai con una mappa chiara dei tuoi colli di bottiglia, indipendentemente da quello che decidi di fare dopo.